El reto
Necesito inglés para entrevistas y trabajo remoto hacia enero de 2027, sobre todo para hablar en stand-ups, design reviews y llamadas. Quería algo tipo Duolingo, pero con las situaciones de mi trabajo. Soy el único usuario, así que los datos son muy detallados y solo hablan de mí. No demuestran que la app le sirva a alguien más.
Proceso
Investigación
La app arrancó suponiendo que yo tenía B1. Tres semanas después hice una medición de nivel y salió A2+, así que todo ese tiempo había practicado un nivel arriba del mío. En esos 23 días y 56 horas de uso apareció mi problema principal. Por escrito sé usar los auxiliares y hablando desaparecen. En una llamada decía «I share the usability test by Thursday», sin el will. Más explicación no iba a arreglar eso. Hacía falta practicar hablando y con presión de tiempo.
Diseño
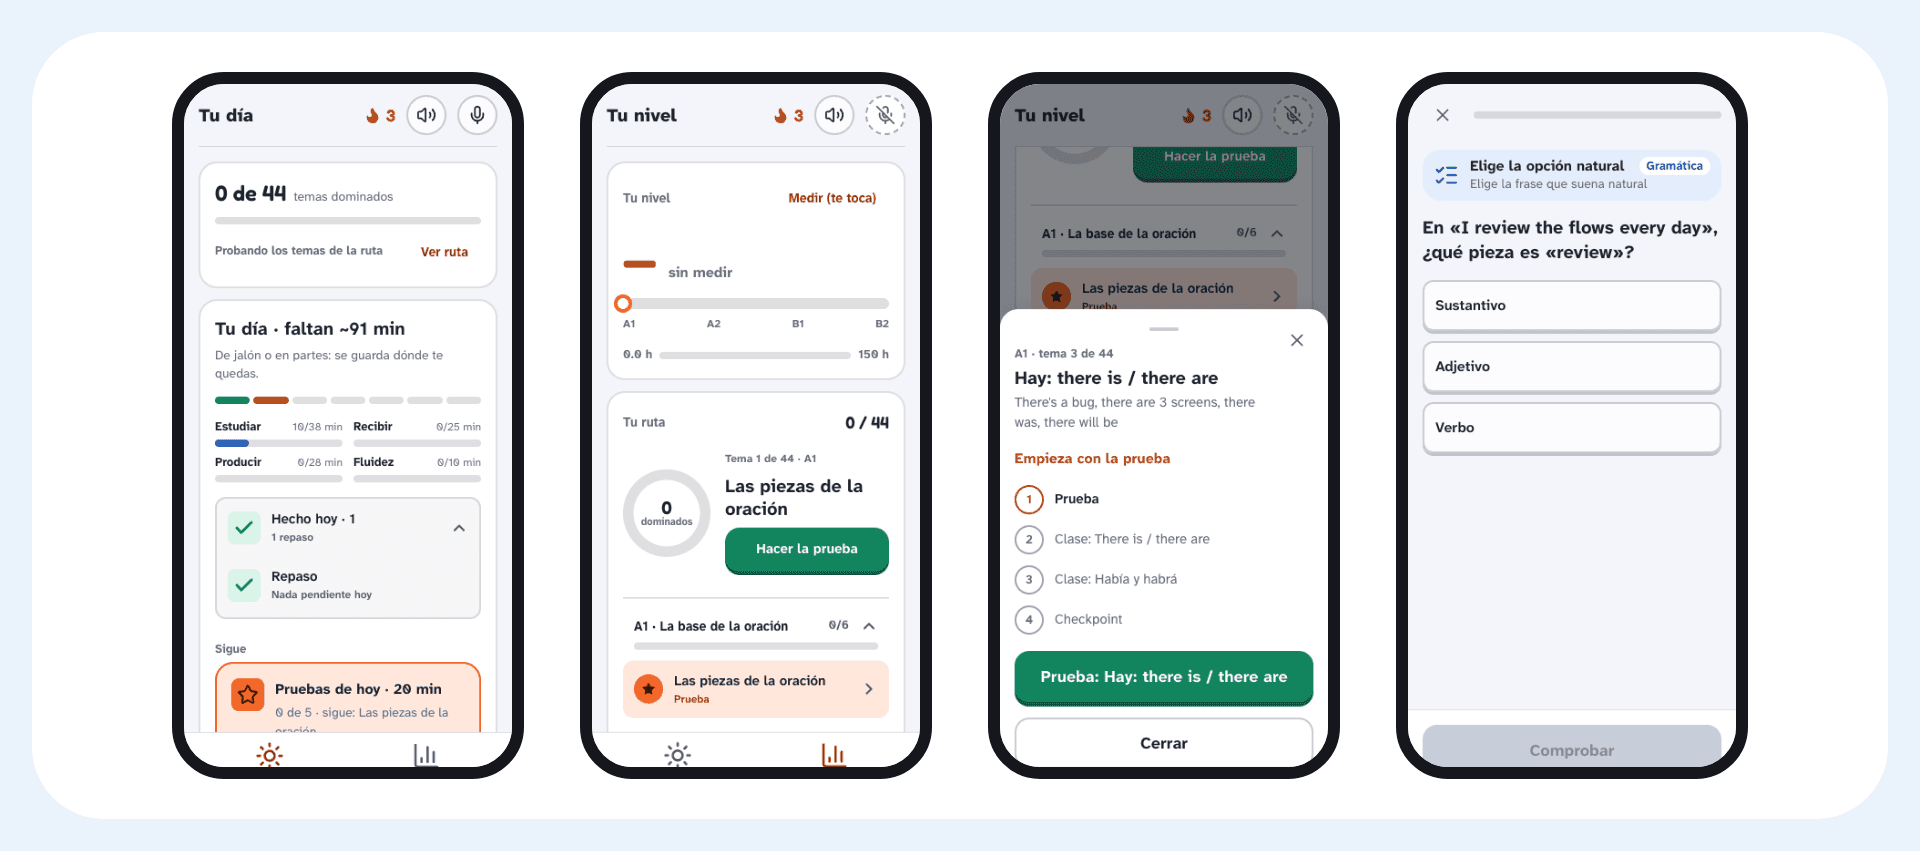
Con esos datos rehíce el plan desde cero. La ruta quedó en 44 temas en el orden del English Grammar Profile de Cambridge, y cada tema empieza con una prueba y sigue con clase y checkpoint. Vi que mi tiempo se iba cerca de 60% en estudiar el idioma y 1% en recibir inglés que entendiera, cuando el modelo de Nation pide repartirlo en cuatro partes iguales. Ahora cada paso del día lleva su parte y una barra muestra cómo voy. También dejé que mis quejas de usuario pesaran. «Siento que no avanzo» se volvió «Pruebas de hoy», y dejé la app en dos pestañas para que hubiera un solo camino.
Desarrollo / Automatización
Empezó como un artefacto de Claude y el 19 de octubre la mudé a Vercel, con Supabase para el progreso y Whisper para transcribir mi voz. La construí con Claude Code, con más de 220 commits en 16 días. Ahora la estoy migrando a una app nueva en Next.js y TypeScript, con tokens y componentes en Storybook, mientras sigo usando la anterior todos los días.
Análisis de datos
Un ejercicio me explicó la voz pasiva sin que yo la hubiera visto y pedí auditar todo. Cerca de 1 de cada 6 errores guardados marcaba como error algo correcto o enseñaba una regla falsa. Esas correcciones entraban a mi repaso y la IA fabricaba más ejercicios a partir de ellas. Medí al corrector con 60 frases, mitad correctas y mitad con errores reales, y elegí modelo y pregunta con ese resultado. Ahora un segundo modelo confirma antes de que algo cuente como error. Cada semana un bot lee mis datos y propone cambios con su evidencia y su costo, y yo decido cuáles se aplican.
Rol y herramientas
Rol
- Diseño de producto
- Desarrollo
- Análisis de datos
- Sistema de diseño
- Usuario de prueba
Herramientas
- Claude Code
- Next.js
- TypeScript
- Storybook
- Supabase
- Whisper
- Vercel
Resultados
- La medición de A2+ cambió el punto de partida y la ruta se rehízo con ese nivel
- En la prueba de 60 frases, las correctas marcadas como error bajaron de 20% a 0%, y al corrector nuevo se le escapó 2% de los errores reales
- Quité 29 de 150 errores guardados y 28 de 200 ejercicios generados que enseñaban algo mal
- La auditoría completa encontró 50 problemas graves y 108 menores, y casi todos los graves estaban en contenido generado por IA
- Cuesta cerca de 10 USD al mes, medidos en noviembre
- Todavía no hay una segunda medición de nivel, así que aún no puedo decir cuánto subí
Aprendizajes
Lo que genera la IA no debería llegar directo a alguien que está aprendiendo. Un error del corrector se repite en el repaso y se multiplica en ejercicios nuevos, y quien aprende no tiene cómo notarlo. También aprendí a desconfiar de mí como usuario. Pedí cosas que no me ayudaban a aprender, y una vez tuve que reclamar «me debiste decir que no». Ahora cada decisión de enseñanza dice si viene de un estudio o de criterio propio.